数据库出现死锁怎么排查
数据库出现死锁怎么排查
面试指北 · 蔚来
回答问题前,先自测下
图片上的问题是否会出现死锁(字节)
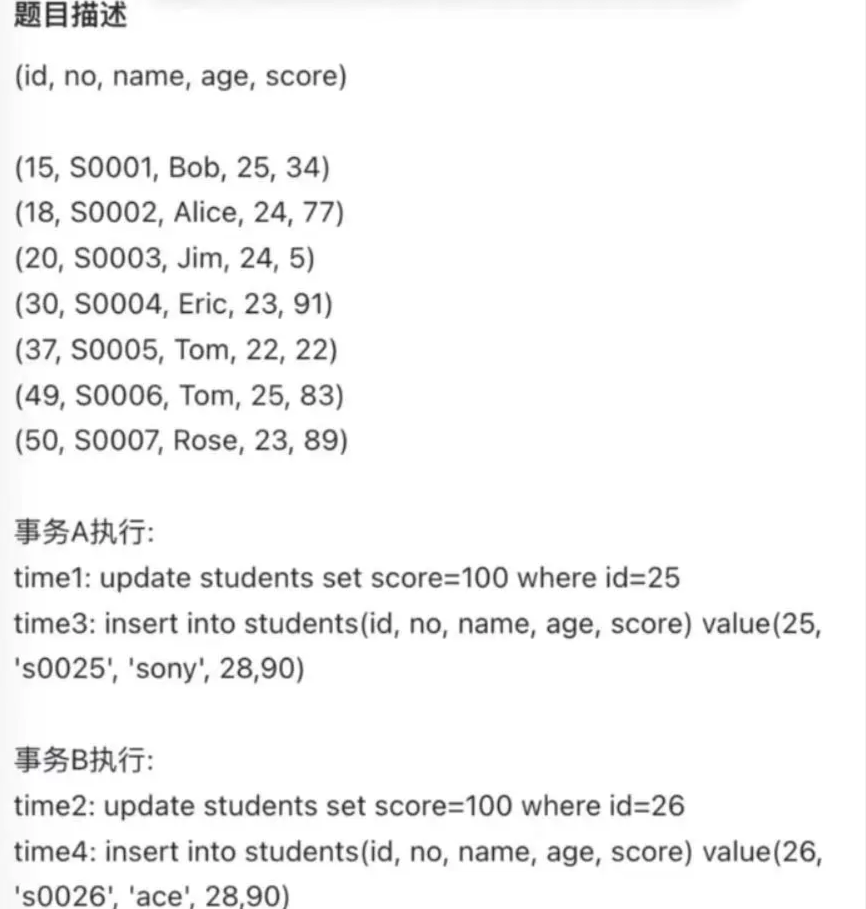
是否会发生死锁,很大程度取决于事务的并发执行时机以及数据库的隔离级别。在 MySQL 默认的 InnoDB + REPEATABLE READ 隔离级别下,这样“UPDATE 不存在的行 + 再 INSERT 同一主键”的操作模式,有相当大概率触发死锁,尤其当两个事务几乎同时执行时。
下面先说明为什么“更新一个不存在的主键值”可能会导致锁冲突,然后再结合题目示例分析可能出现的死锁过程,最后给出关键结论。
1. 为什么“UPDATE 不存在的行”也会加锁?
在 InnoDB 的 REPEATABLE READ 隔离级别下,执行
UPDATE students
   SET score = 100
 WHERE id = 25
即使 id = 25 在表中并不存在,InnoDB 也会对“满足 WHERE 条件所对应的键值区间”加上 Next-Key Lock(行锁+间隙锁)。简单说:
- 键值锁(Record Lock):如果那条记录真实存在,就锁定那行。
- 间隙锁(Gap Lock):如果记录不存在,就锁定“它所应该出现的那个位置”对应的间隙,防止其他事务在同一范围插入或修改记录,避免幻读。
所以,更新一个并不存在的 id=25,依然会在索引上占用某个区间锁(一般会锁住 (20, 30] 这样的范围,具体要看表里已有的主键分布)。如果另一个事务同样“UPDATE 不存在的行”落在同一个间隙范围,就会出现相互等待的潜在风险。
2. 结合题目场景,看死锁如何产生
题目中已有的 id 分布为:
(15), (18), (20), (30), (37), (49), (50)
并没有 25 和 26。再看两个事务的操作:
- 事务A
- time1:
UPDATE students SET score=100 WHERE id=25; - time3:
INSERT INTO students(id, no, name, age, score) VALUES(25, 's0025', 'sony', 28, 90); - 事务B
- time2:
UPDATE students SET score=100 WHERE id=26; - time4:
INSERT INTO students(id, no, name, age, score) VALUES(26, 's0026', 'ace', 28, 90);
2.1 可能的死锁过程
- 事务A 执行 time1(UPDATE 25),发现没有
id=25这行,于是获取了“主键索引中 20 和 30 之间”的间隙锁。 - 事务B 几乎同时执行 time2(UPDATE 26),也发现没有
id=26,于是同样要锁 “20 和 30 之间” 的某个区间——这个动作可能与事务A的锁范围部分重叠或相互影响。此时可能出现 T1持有一部分间隙锁,T2持有另一部分间隙锁 的情况。 - 之后 事务A 去执行 INSERT (25,...),事务B 去执行 INSERT (26,...);由于先前各自占据了部分间隙锁,这一步往往需要对方释放某些锁才能继续插入。由此就形成了经典的互相等待——死锁。
当然,这取决于两个事务交错执行的先后顺序和并发程度;如果 A 的所有操作都跑完才轮到 B,或 B 先执行完再轮到 A,通常就不会死锁。
在实践中,你经常会在错误日志中看到诸如
Deadlock found when trying to get lock; try restarting transaction
的提示,这就是数据库发现死锁后回滚其中一个事务的表现。
3. 为什么在 READ COMMITTED 下死锁概率会降低?
-
REPEATABLE READ下的 Next-Key Lock
在 MySQL 默认隔离级别(REPEATABLE READ)中,为防止幻读,InnoDB 会对区间加锁(Gap Lock),也就是我们说的“更新不存在的 id=25 也会锁一个间隙”。 -
READ COMMITTED下的锁策略更松
在
READ COMMITTED
级别下,InnoDB 通常只会对实际存在的记录加锁,不会对区间做那么严格的 Gap Lock(除非遇到特殊事务或语句),这样大大减少了更新空主键值时所产生的大范围“间隙锁”。
- 间隙锁减少,两个事务真正冲突锁资源的机会也随之降低,死锁概率变小。
注意:
READ COMMITTED并不是绝对杜绝死锁,只是由于“锁范围更小”而降低了出现死锁的机会。对于某些高并发、高冲突场景,死锁依然可能发生。
4. 小结
- 这个场景下会不会死锁?
- 有很大可能,特别是在 MySQLREPEATABLE READ模式、两条更新都针对“不存在的行”,且操作几乎同时发生时,很容易触发间隙锁冲突从而导致死锁。 - 为什么会死锁?
- 更新一个不存在的主键值时,InnoDB 不仅要锁住这行,还要对对应的索引区间(Gap)加锁。两个事务锁定了同一段区间的不同部分后,再分别去插入各自的记录,容易互相等待。 - 为什么
READ COMMITTED会减少死锁?
- 该隔离级别下对不存在的记录往往不再大范围加 Gap Lock,真正的锁冲突范围小了,死锁概率随之降低。
总体来看,如果这两个事务真的在“更新不存在的行 + 再插入同样主键”这一模式上高并发执行,确实存在死锁隐患。在生产环境下通常会建议:
- 逻辑上尽量避免对“可能不存在的主键”直接
UPDATE。 - 如果必须要做“先 UPDATE 再 INSERT”,要么在应用层做存在性判断、要么降低隔离级别或采用其他设计方式。
- 即便如此,仍应在代码层面对
Deadlock found... try restarting transaction进行重试处理,以保证业务流程的正确性。
数据库出现死锁怎么排查
一、死锁的定义
死锁是指两个或多个事务在执行过程中因争夺资源而造成的一种互相等待的现象,若无外力干涉,它们将无法推进。
二、死锁排查步骤
1. 使用数据库连接软件解锁
1.1 查询当前连接进程
使用如下命令查看当前连接的所有进程:
SHOW PROCESSLIST;
- Id: 进程编号。
- Command: 命令类型(如
Query)。 - State: 当前状态。
- Info: 正在执行的 SQL 语句。
1.2 杀死特定进程
根据SHOW PROCESSLIST的结果,使用KILL命令结束死锁进程:
KILL <process_id>;
验证是否还有锁存在:
SHOW OPEN TABLES WHERE In_use > 0;
1.3 查询锁状态
通过information_schema查询当前锁信息:
SELECT * FROM INFORMATION_SCHEMA.INNODB_LOCKS;
SELECT * FROM INFORMATION_SCHEMA.INNODB_LOCK_WAITS;
上述命令可以看到:
- 当前持有锁的事务 ID。
- 等待的锁及事务间的依赖关系。
1.4 使用 InnoDB 状态排查
通过如下命令查看详细的锁等待和事务信息:
SHOW ENGINE INNODB STATUS;
重点关注以下部分:
- TRANSACTIONS: 列出当前所有事务。
- LOCK WAIT: 查看等待时间较长的事务。
2. 使用调试工具进行排查
2.1 mysqladmin debug
使用命令生成调试日志:
mysqladmin -S /tmp/mysql.sock debug
然后在 MySQL 的错误日志中查看阻塞线程。
2.2 启用 InnoDB Lock Monitor
创建一个名为innodb_lock_monitor的表启用锁监控:
CREATE TABLE innodb_lock_monitor (a INT) ENGINE=INNODB;
再次查看锁信息时会更详细。
三、死锁的原因
1. 锁顺序不一致
当多个事务获取锁的顺序不一致时,容易导致死锁。
示例
事务 A:
BEGIN;
UPDATE TableA SET col = 'X' WHERE id = 1;
UPDATE TableB SET col = 'Y' WHERE id = 2;
事务 B:
BEGIN;
UPDATE TableB SET col = 'X' WHERE id = 2;
UPDATE TableA SET col = 'Y' WHERE id = 1;
两个事务互相等待对方释放锁,形成死锁。
解决办法
- 统一锁顺序:确保所有事务按照固定的顺序请求锁。
2. 索引缺失导致范围锁
当查询条件未命中索引时,会对大量行加锁,增加死锁概率。
示例
UPDATE orders SET status = 'shipped' WHERE user_id = 1001;
若user_id无索引,则会锁住整个表。
解决办法
- 增加索引:在查询条件涉及的列上添加索引。
- 缩小锁范围:添加更精确的过滤条件。
3. 大事务导致资源争夺
长时间运行的大事务会持有锁较长时间,其他事务可能因等待锁而产生死锁。
示例
事务 A:
UPDATE orders SET status = 'shipped' WHERE id BETWEEN 1 AND 10000;
事务 B:
UPDATE orders SET status = 'paid' WHERE id BETWEEN 5000 AND 15000;
解决办法
- 拆分事务:将大事务拆分为多个小事务,分批执行。
- 避免热点更新:通过分库分表或分区减小热点数据。
4. 隔离级别导致的锁范围
MySQL 默认的 REPEATABLE READ 隔离级别会使用 Next-Key Lock 锁住记录及其间隙,增加了死锁风险。
解决办法
- 将隔离级别调整为
READ COMMITTED
,减少锁范围。
sql
  SET GLOBAL TRANSACTION ISOLATION LEVEL READ COMMITTED;
四、死锁的解决办法
1. 代码优化
- 统一锁顺序:确保事务按固定顺序请求锁。
- 控制事务大小:减少事务中处理的记录数,缩短事务执行时间。
- 优化查询条件:通过添加索引或限定范围减少锁定行数。
2. 数据库层面优化
-
调整隔离级别:选择更低的隔离级别(如
READ COMMITTED)。 -
分库分表:减少单表并发访问。
-
监控与重试
:捕获死锁异常,进行重试。
java
  for (int i = 0; i < maxRetries; i++) {
      try {
          // 执行事务逻辑
          break;
      } catch (DeadlockException e) {
          // 记录日志并重试
      }
  }
3. 工具使用
- 定期查询
information_schema和SHOW ENGINE INNODB STATUS。 - 在监控系统中加入死锁检测报警。
五、总结
死锁是数据库高并发场景下难以避免的问题,通过以下方式可以减少死锁的发生:
- 优化 SQL 语句和索引设计。
- 控制事务粒度,避免大范围锁。
- 调整数据库隔离级别,减少锁冲突。
- 使用监控工具实时排查锁问题。
即使发生死锁,也可以通过合理的日志监控和事务重试机制保障服务的稳定运行。