JVM 频繁 Full GC 的排查与解决思路(面试指北 · 蔚来)
JVM 频繁 Full GC 的排查与解决思路(面试指北 · 蔚来)
面试指北 · 蔚来
题意
“JVM 出现频繁 Full GC 该如何解决?”是 Java 后端面试里很典型的一道线上问题排查题。面试官通常不是只想听一句“把堆调大”,而是想看你能不能按顺序说清楚:
- Full GC 有哪些常见触发条件;
- 频繁 Full GC 会带来什么影响;
- 线上如何确认“确实频繁”、如何拿到现场信息;
- 怎么区分是内存泄漏、对象分配过快、参数不合理、元空间问题还是显式 GC;
- 采取哪些措施,以及优化后如何验证。
所以这题更适合答成一套“先定位、再处理、后验证”的排查框架,而不是直接背 JVM 参数。
结论
遇到频繁 Full GC,核心思路是先判断“Full GC 后内存能不能降下来”:
- 如果 Full GC 后老年代占用明显下降,但很快又涨满,更多考虑分配速率过高、对象晋升过快、年轻代偏小、缓存或大对象过多、并发量超出内存容量;
- 如果 Full GC 后老年代几乎不降,优先怀疑内存泄漏,或者对象生命周期过长、被静态集合等长期持有;
- 如果堆内存并不高但 Full GC 频繁,要关注元空间、显式
System.gc()、大对象分配、收集器配置等问题。
整体答题框架可以概括为:
先开 GC 日志和监控确认频率与耗时 → 用
jstat、jmap、堆转储和 MAT 定位内存分布 → 结合代码与配置判断根因 → 修复泄漏或调整参数/回收器/并发限制 → 压测和监控验证效果。
生产上还可以先做应急止血,例如限流、摘流量、回滚可疑变更、临时扩容,同时保留 GC 日志和堆现场,再继续分析。扩容和重启更多是止血,不是根治。
要点展开
1. Full GC 的常见触发条件
(1)老年代空间不足
新生代对象晋升到老年代时,如果老年代剩余空间不足,或者没有足够连续空间完成分配,就可能触发 Full GC。常见表现包括晋升失败、分配担保失败等。对象分配速率过高、对象存活时间过长、年轻代偏小,都可能让对象更快涌入老年代。
(2)永久代/元空间满了
JDK 8 以前有永久代,永久代满会触发 Full GC;JDK 8 以后永久代被元空间取代,元空间使用本地内存,但元空间不足时同样可能触发 Full GC,严重时出现 Metaspace 相关 OOM。动态生成类、反射、CGLIB 代理、热部署等场景要特别关注元空间。
(3)手动调用 System.gc()
代码或第三方组件显式调用 System.gc() 可能触发 Full GC。是否真正执行、执行范围多大,还取决于收集器和 JVM 参数,例如启用 -XX:+DisableExplicitGC 后显式 GC 会被忽略。
(4)内存分配策略问题
如果老年代剩余连续内存空间小于新生代对象晋升所需空间,或者分配时找不到合适区域,也可能触发 Full GC。这类问题和堆碎片、对象晋升速度、年轻代大小都有关系。
(5)存在大对象
大对象可能直接进入老年代,频繁创建大对象会快速抬高老年代占用。比如一次性读取大文件、返回超大 JSON、一次查询大量数据、请求头过大等。注意 -XX:PretenureSizeThreshold 主要对部分收集器有效,G1 下还有 humongous region 的概念,大对象会占用连续 Region,带来额外压力。
(6)收集器自身原因
如果使用 CMS,promotion failed、concurrent mode failure 也可能导致 Full GC;G1 在疏散失败等情况下也可能退化为 Full GC。回答时可以不展开,但提到“不同收集器的 Full GC 触发原因不完全一样”会更加完整。
2. 频繁 Full GC 的影响
- 全局暂停(Stop-the-World):Full GC 通常会暂停应用线程,频繁发生会直接影响接口响应时间。
- 吞吐量下降:大量 CPU 时间花在 GC 上,业务处理效率下降,严重时出现超时、熔断、雪崩。
- 可能导致 OOM:如果 Full GC 后仍无法回收足够内存,最终可能抛出
OutOfMemoryError。 - 间接放大故障:GC 频繁会拖慢线程池任务、数据库连接释放、消息消费等,故障面可能不止 JVM 本身。
3. 排查 Full GC 的步骤
3.1 启用并分析 GC 日志
JDK 8 及以前常用参数:
-XX:+PrintGCDetails -XX:+PrintGCTimeStamps -Xloggc:/path/to/gc.log
带日志轮转的写法:
-Xloggc:gc.log -XX:+PrintGCDetails -XX:+PrintGCTimeStamps -XX:+UseGCLogFileRotation -XX:NumberOfGCLogFiles=8 -XX:GCLogFileSize=8m
JDK 9 及以上可以使用统一的日志参数,例如:
-Xlog:gc*:file=gc.log:time,uptime,level,tags:filecount=8,filesize=8m
看日志时重点看:
- Full GC 发生的频率和单次耗时;
- Full GC 前后老年代占用是否下降;
- 触发原因,例如分配失败、元空间阈值、显式 GC、收集器失败等;
- Young GC 频率、对象晋升速度、每次晋升到老年代的大小。
3.2 使用工具查看内存分布
- 查看对象分布:
jmap -histo:live <pid>
jmap -histo:live 通常会先触发一次 GC 来统计存活对象,生产执行要评估 STW 和性能影响。
- 导出堆转储文件:
jmap -dump:format=b,file=heapdump.hprof <pid>
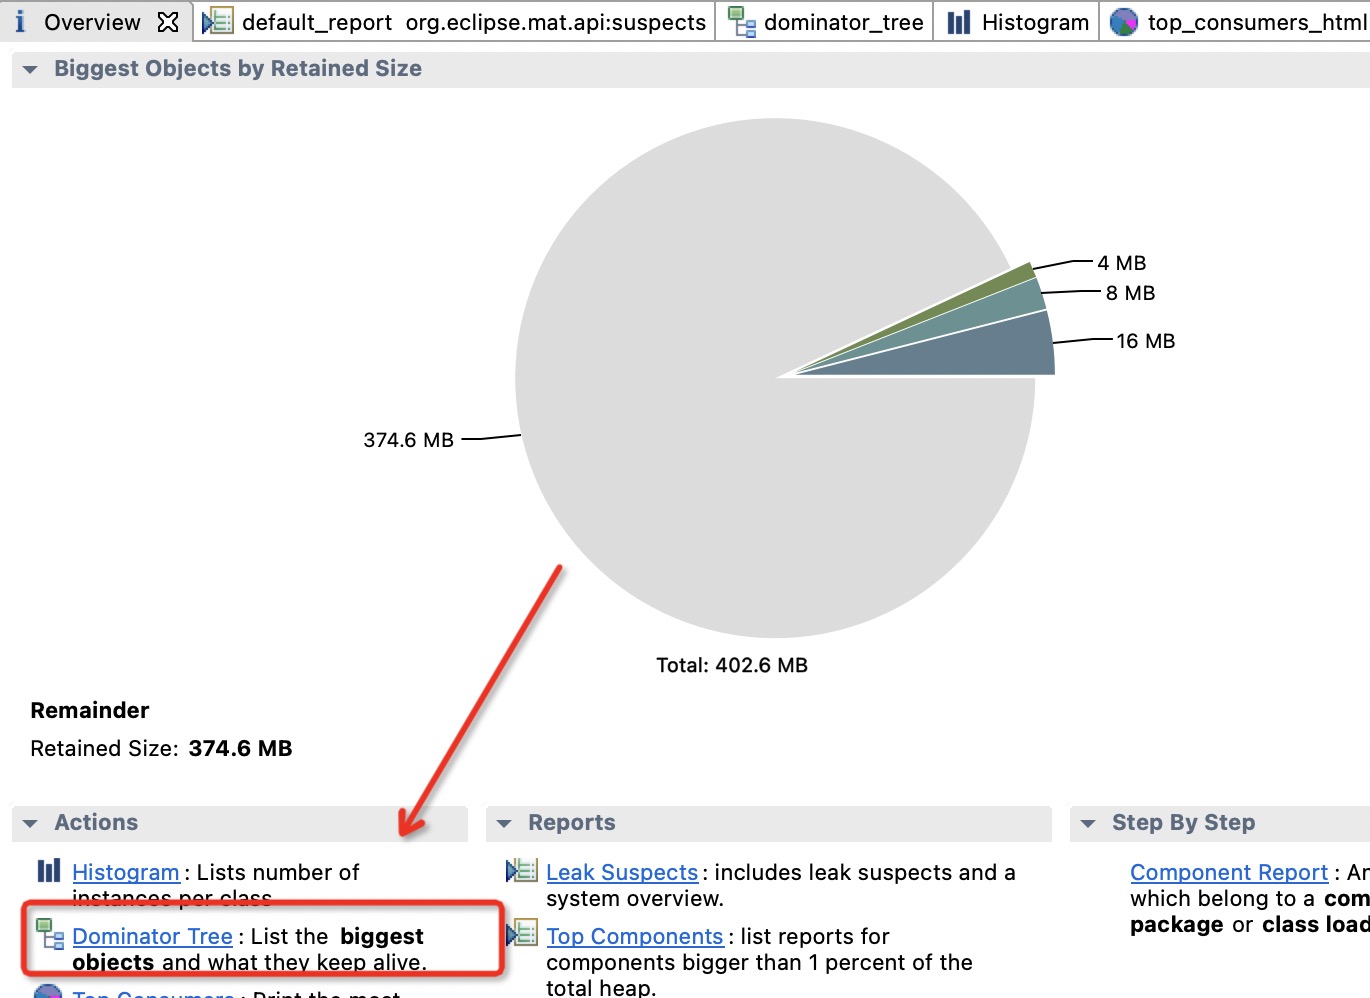
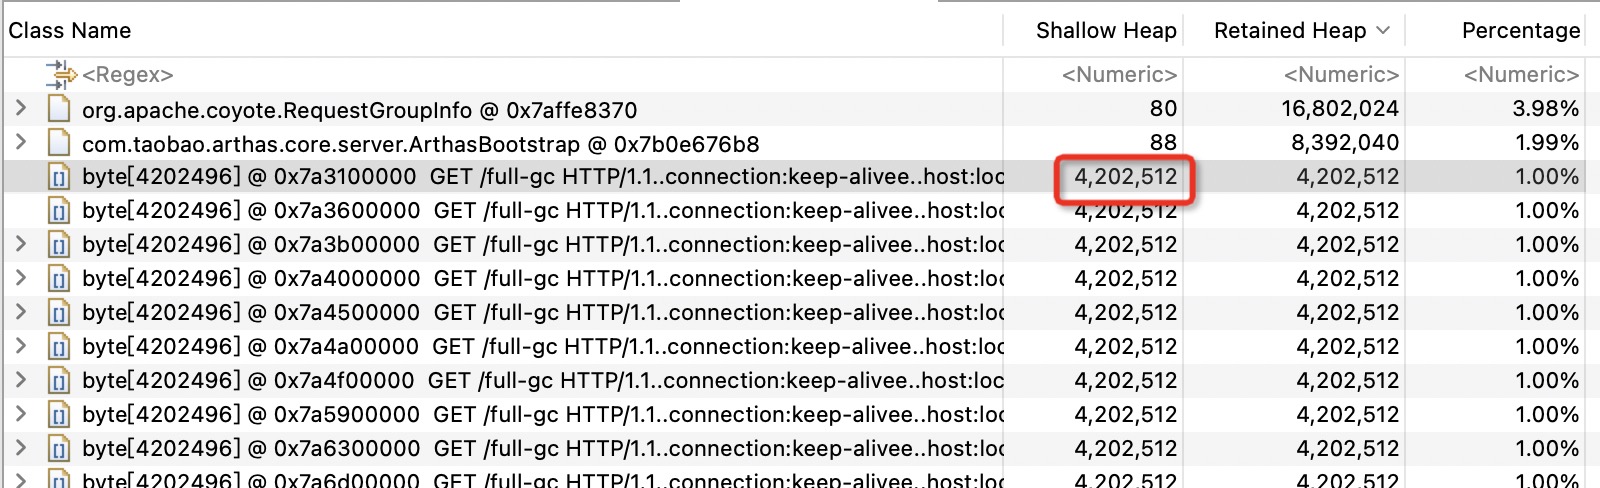
然后使用 MAT 分析内存占用,重点看支配树、Leak Suspects、大对象和对象引用链。
- 监控老年代和元空间使用率:
jstat -gcutil <pid> 1000
重点关注 O(老年代使用率)、M(元空间使用率)、FGC(Full GC 次数)、FGCT(Full GC 总耗时)。如果 FGC 持续增长,且 FGCT 占应用运行时间比例明显升高,就说明 GC 已经成为性能问题。
3.3 排查配置和代码问题
- 检查
server.max-http-header-size或类似配置是否设置过大。请求头过大时,解析过程中可能产生较大的字节数组或字符串,属于大对象来源之一。 - 查看是否存在上传大文件、一次性读取大文件、一次性查询大量数据、拼接超大 JSON 等逻辑。
- 检查缓存是否有上限和过期策略,静态集合是否持续增长,
ThreadLocal是否及时remove,流和连接是否关闭。 - 检查是否有动态生成类、热部署、反射代理等导致元空间持续增长的场景。
3.4 使用 Arthas 深入分析
- 列出最忙的线程,观察 GC 线程占用情况:
thread -n 3 -i 1000
"GC Thread#3" [Internal] cpuUsage=47.06% deltaTime=473ms time=5430ms

"GC Thread#6" [Internal] cpuUsage=46.34% deltaTime=465ms time=5383ms

"GC Thread#4" [Internal] cpuUsage=45.71% deltaTime=459ms time=5358ms
- 导出活跃对象:
heapdump --live /tmp/dump.hprof
然后使用 MAT 读取 hprof 文件。--live 通常用于只保留存活对象,执行时同样要评估对生产应用的影响。
4. 解决频繁 Full GC 的措施
4.1 调整 JVM 参数
合理设置堆内存大小,示例:
-Xms4g -Xmx4g -Xmn2g
说明:-Xms 和 -Xmx 一般建议设置为相同,避免堆动态伸缩带来额外波动。-Xmn 是示例,使用 G1 时是否固定年轻代要结合版本和压测结果,很多场景更常用 -XX:MaxGCPauseMillis 让 G1 自适应调整。
设置元空间大小:
-XX:MetaspaceSize=256m -XX:MaxMetaspaceSize=512m
MetaspaceSize 更像首次触发元空间 GC 的阈值,MaxMetaspaceSize 是上限,具体值要结合应用动态类数量评估。
使用适合的垃圾回收器,例如 G1:
-XX:+UseG1GC
-XX:MaxGCPauseMillis=200
MaxGCPauseMillis 是目标值,不是硬保证。调参后要通过 GC 日志和压测验证,而不是设置完就认为问题解决。
4.2 优化代码
- 避免内存泄漏:检查静态集合类的无用引用;缓存设置容量上限和淘汰策略;
ThreadLocal使用后及时remove;监听器、回调、连接、流等资源及时释放。 - 减少大对象分配:大文件上传改为流式处理;大查询分页;避免一次性把大量数据查入内存;避免频繁创建超大数组、超大字符串和超大 JSON。
- 控制对象生命周期:如果对象创建很快、存活时间又长,会加速晋升到老年代,需要从业务逻辑上减少不必要的长生命周期对象。
4.3 优化并发配置
调整请求头大小限制,例如:
server:
  max-http-header-size: 8096
同时要合理设置并发量、上传大小限制、连接池和线程池,避免瞬时请求量超过内存承载能力。并发限制不是“治 GC”的万能药,但在分配速率过高时是有效的止血手段。
4.4 避免手动调用 System.gc()
如果需要禁用显式 GC 调用,可以配置:
-XX:+DisableExplicitGC
但要谨慎:有些依赖直接内存的组件可能间接依赖 GC 来触发 DirectByteBuffer 的清理,禁用显式 GC 后要关注直接内存使用情况,避免出现直接内存 OOM。
4.5 提升硬件资源
增加堆内存可以缓解频繁 Full GC,但前提是已经确认没有明显内存泄漏。如果是泄漏,单纯扩容只是把 OOM 时间往后推;如果是容量不足,扩容后还要继续观察对象分配速率和 GC 频率。
5. 验证优化效果
- 压测验证:使用 JMeter 等工具模拟实际并发场景,观察 Full GC 频率、单次耗时和老年代增长趋势。
- 监控工具:使用 VisualVM、
jvisualvm或线上监控系统实时观察 GC 行为,安装 GC 插件分析回收情况。 - 持续迭代:根据监控数据继续调整内存配置、缓存策略和代码逻辑。GC 调优通常不是一次完成的,而是“观察—调整—验证”的循环。
易错点与对比
- Full GC 次数多不等于一定是内存泄漏。关键看 Full GC 后老年代是否下降,以及下降后多久再次涨满。
- 不要一上来就调大
-Xmx。堆越大,单次 Full GC 可能越久;如果是泄漏,扩容只是延后问题。 jmap -histo:live和堆转储不是完全无代价的。生产执行可能带来 STW 和磁盘 IO 压力,尽量在低峰期、摘流量或保留现场时执行。- JDK 8 的永久代和元空间不是一回事。JDK 8 以后没有永久代,元空间使用本地内存,元空间问题要看
Metaspace相关日志和监控。 - G1 下不要盲目照搬
-Xmn。G1 更强调停顿目标,固定年轻代可能影响其自适应策略,是否设置要结合版本和压测。 -XX:+DisableExplicitGC有副作用。它可能影响依赖System.gc()触发清理的直接内存回收,使用前要评估。server.max-http-header-size的单位和版本有关,通常按字节理解。请求头过大只是大对象来源之一,不能解释所有 Full GC。- 大对象阈值不是所有收集器都适用。
PretenureSizeThreshold主要对部分收集器有效,G1 要关注 humongous region。 - Young GC 和 Full GC 要分开看。Young GC 频繁不一定可怕,Full GC 频繁且耗时长更危险;不同收集器的日志名称和触发原因也不同。
- Full GC 后老年代下降明显但仍频繁,要重点看分配速率、晋升速度、年轻代大小、缓存和大对象;几乎不下降则优先排查泄漏和长生命周期对象。
小结
JVM 频繁 Full GC 通常与内存分配策略、垃圾回收器选择、代码实现和配置相关。回答这类题时,建议按“确认现象 → 分析日志和内存 → 定位根因 → 修复泄漏/调整参数/限制并发 → 压测和监控验证”的顺序展开。记住一句话:先判断 Full GC 后内存能不能降下来,再决定是查泄漏、降分配速率,还是调参数和扩容。