Java / K8s 线上问题排查
一、如何定位容器或 Pod 的问题来源
1. 使用 Kubernetes 和 Docker 的监控工具
要确定哪个服务或容器可能存在问题,可以利用监控工具来查看资源使用情况,例如:
- Kubernetes 环境:
- Prometheus 和 Grafana:Prometheus 可以抓取 Kubernetes 集群中所有 Pod 和节点的资源使用数据,Grafana 可以以可视化图表的形式展示这些数据。这些工具可以帮助你快速找到哪个 Pod 出现了异常的 CPU、内存使用情况。
- kubectl top 命令:可以查看节点和 Pod 的资源使用情况。
bash kubectl top pod -n <namespace> kubectl top node - Docker 环境:
- Docker Stats:可以查看所有容器的资源使用情况,帮助你识别哪个容器占用的资源过高。
bash
    docker stats
2. Kubernetes 日志与事件查看
- 查看 Pod 的日志:
- 通过
kubectl logs命令查看具体 Pod 的日志,检查是否存在异常的错误信息。
bash kubectl logs <Pod名> -n <namespace> - 查看 Pod 的状态:
- 使用
kubectl describe pod <Pod名> -n <namespace>查看 Pod 的事件和状态,检查是否有重启、崩溃等异常情况。
二、具体服务的深入排查
1. CPU 占用高的深入排查
在 Kubernetes 环境下
-
定位异常 Pod:
使用kubectl top pod来找到 CPU 占用高的 Pod:
bash
   kubectl top pod -n <namespace>
找到 CPU 占用异常的 Pod。 -
进入 Pod 排查线程:
可以进入该 Pod 内部的容器,进一步查看具体的 Java 进程状态。
bash
   kubectl exec -it <Pod名> -n <namespace> -- /bin/bash
进入容器后,使用top或htop来确认哪个线程 CPU 占用最高。 -
通过
jstack分析线程栈:
如果确认某个 Java 线程 CPU 占用过高,可以使用jstack打印线程栈来分析。
bash
   jstack <Java进程ID> > thread_dump.txt
使用top -H -p <Java进程ID>获取线程 ID,并通过转换为 16 进制来找到具体线程。
比如生成如下的内容
```
"d-m-pool-1731" #1358923 prio=5 os_prio=0 cpu=146.47ms elapsed=1359.17s tid=0x00007f4258025000 nid=0x1d42 waiting on condition [0x00007f421e932000]
java.lang.Thread.State: WAITING (parking)
at jdk.internal.misc.Unsafe.park(java.base@14.0.1/Native Method)
- parking to wait for <0x000000075906e938> (a java.util.concurrent.SynchronousQueue$TransferStack)
at java.util.concurrent.locks.LockSupport.park(java.base@14.0.1/LockSupport.java:211)
at java.util.concurrent.SynchronousQueue$TransferStack.awaitFulfill(java.base@14.0.1/SynchronousQueue.java:460)
at java.util.concurrent.SynchronousQueue$TransferStack.transfer(java.base@14.0.1/SynchronousQueue.java:361)
at java.util.concurrent.SynchronousQueue.take(java.base@14.0.1/SynchronousQueue.java:920)
at java.util.concurrent.ThreadPoolExecutor.getTask(java.base@14.0.1/ThreadPoolExecutor.java:1056)
at java.util.concurrent.ThreadPoolExecutor.runWorker(java.base@14.0.1/ThreadPoolExecutor.java:1116)
at java.util.concurrent.ThreadPoolExecutor$Worker.run(java.base@14.0.1/ThreadPoolExecutor.java:630)
at java.lang.Thread.run(java.base@14.0.1/Thread.java:832)
"Attach Listener" #1370841 daemon prio=9 os_prio=0 cpu=0.68ms elapsed=0.11s tid=0x00007f433c061000 nid=0x4c63 waiting on condition [0x0000000000000000]
java.lang.Thread.State: RUNNABLE
"VM Thread" os_prio=0 cpu=207885.11ms elapsed=168498.05s tid=0x00007f436c060000 nid=0x17 runnable
"VM Periodic Task Thread" os_prio=0 cpu=192715.49ms elapsed=168498.00s tid=0x00007f436c0cb800 nid=0x22 waiting on condition
JNI global refs: 625, weak refs: 24806
```
每个线程的堆栈信息包括:
- 线程名称和编号。
- 线程的优先级(
prio和os_prio)。 - CPU 消耗时间。
- 线程状态以及线程堆栈信息。
解析:
-
线程名称:
"d-m-pool-1731"是线程的名称,可能是由线程池创建的某个工作线程。 -
线程 ID
:
tid(Thread ID):0x00007f4258025000,线程在 JVM 内部的标识符。nid(Native ID):0x1d42,这个是操作系统中线程的 ID。
-
优先级
:
prio=5:Java 线程优先级。os_prio=0:操作系统级的线程优先级。
-
CPU 消耗:
cpu=146.47ms,表明该线程消耗了 146.47 毫秒的 CPU 时间。 -
线程状态
:
java.lang.Thread.State: WAITING (parking)- 该线程处于 WAITING 状态,表示它正在等待一些操作完成。例如等待某个锁的释放或等待某个条件。
- (parking) 表示线程被挂起,这通常是由于等待任务完成或线程池的工作线程没有新的任务。
堆栈信息:
- 该线程正在等待
SynchronousQueue的队列操作,这意味着它是在等待任务或其他线程的信号来继续执行。 at java.util.concurrent.locks.LockSupport.park(...)表示线程被挂起,等待一个事件,这种情况常见于线程池中的工作线程等待新的任务。
在 Docker 环境下
使用 docker stats 确定具体 CPU 占用高的容器,然后进入容器进行相似的操作。
2. 服务卡顿问题的排查
使用分布式追踪工具
在微服务环境下,服务卡顿很可能是由于链路上某个微服务的响应速度变慢引起的,使用分布式追踪工具可以非常有效地进行问题定位:
- Jaeger 或 Zipkin:这些工具可以对微服务之间的调用链路进行追踪,帮助发现哪个微服务响应缓慢以及瓶颈所在。
3. 内存占用高的排查
在 Kubernetes 环境下
-
使用 kubectl top:
找到占用内存较高的 Pod。
bash kubectl top pod -n <namespace> -
生成 heap dump 文件:
进入目标 Pod 后,生成 heap dump 文件用于进一步分析:
bash
   jmap -dump:format=b,file=/tmp/heap_dump.hprof <Java进程ID>
然后把 heap dump 文件从容器中拷贝出来分析:
bash
   kubectl cp <namespace>/<Pod名>:/tmp/heap_dump.hprof ./heap_dump.hprof
使用 MAT 或其他工具分析 heap dump 文件,检查内存泄漏或大对象分配。
三、集成监控和报警系统
为了实时监控和及时发现 CPU、内存占用异常的问题,推荐在系统中集成监控和报警系统:
- Prometheus + Grafana:用于监控 Kubernetes 集群的 CPU、内存、网络等各项指标,Grafana 可以进行可视化展示,并设置阈值报警。
- ELK(Elasticsearch, Logstash, Kibana):用于日志的集中管理和分析,可以方便地查看服务日志,结合报警策略发现异常情况。
- K8s Horizontal Pod Autoscaler (HPA):在 Kubernetes 中可以使用 HPA 自动扩展 Pod 数量,来应对高 CPU 或内存占用的情况,从而减轻单个 Pod 的压力。
最优方案
使用 arthas,可以使用curl下载到镜像中或者直接dockerfile中加入到打包的镜像
Java 内存占用高查看
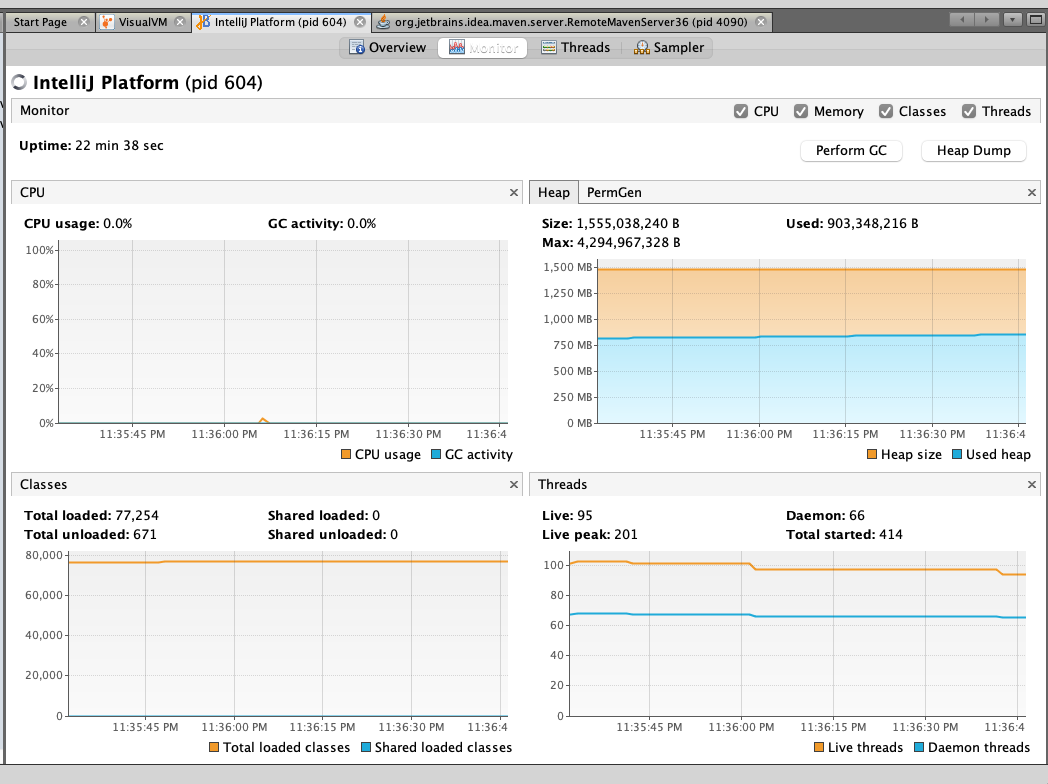
jvisualvm命令,可以使用Java自己的控制台查看内存和GC情况
z